Resultados de pesquisa melhores e mais rápidos
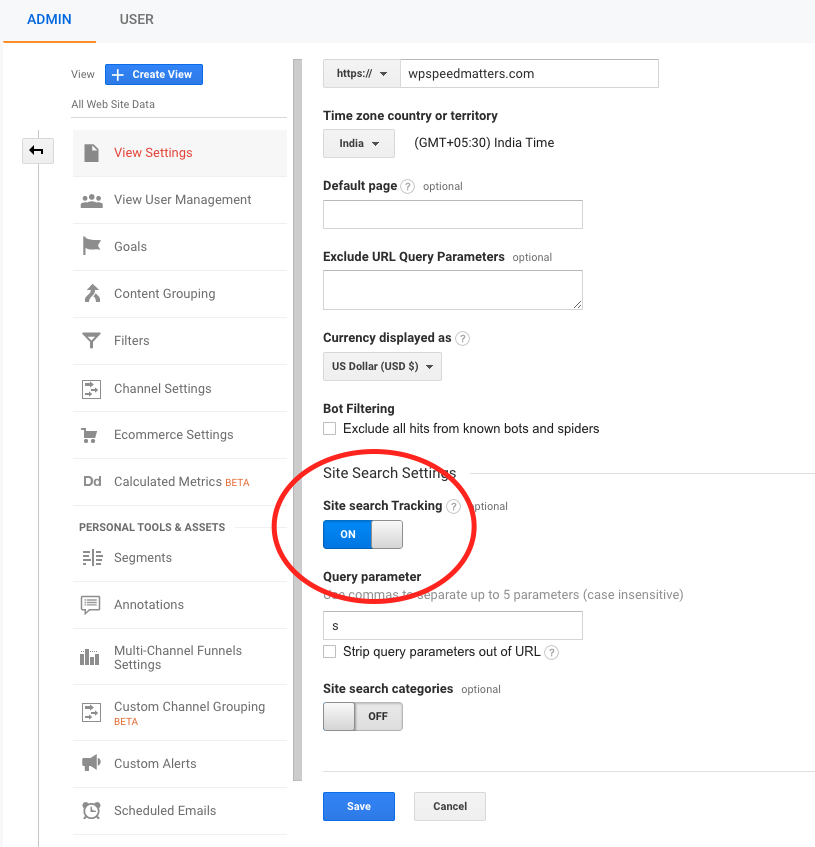
Recentemente, ativei o 'Acompanhamento de pesquisa de sites' no Google Analytics para ver o que as pessoas estão pesquisando em meu blog.
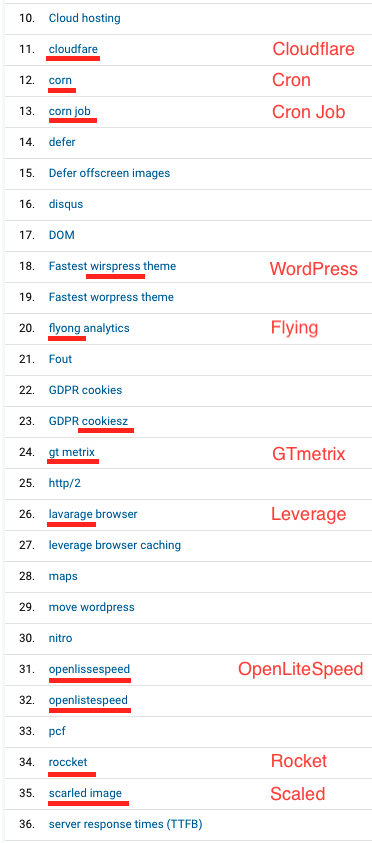
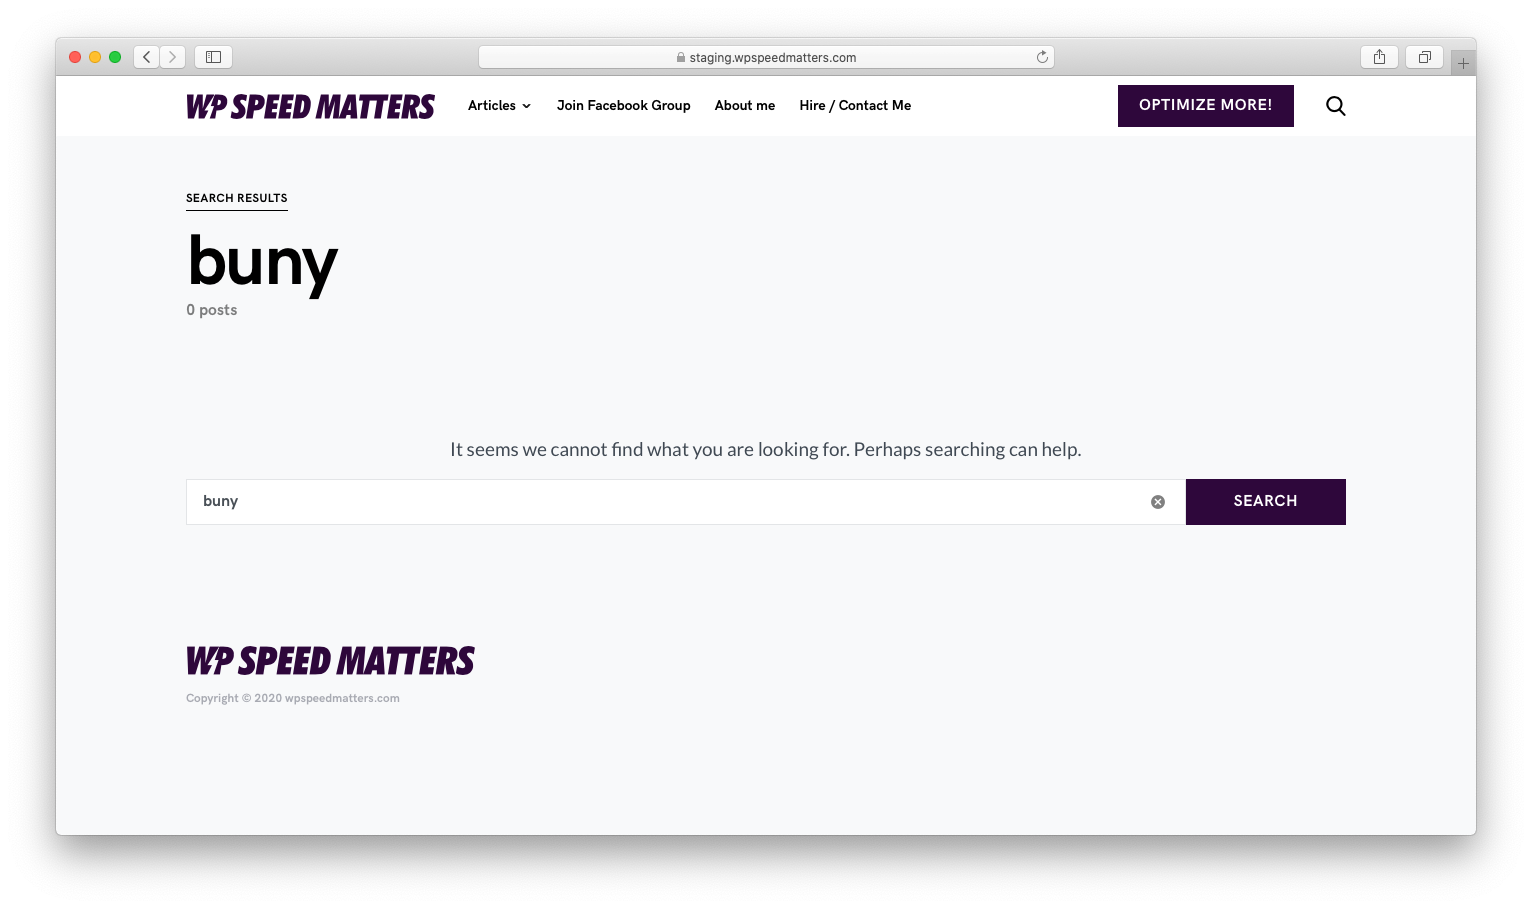
Os resultados foram bastante interessantes. Uma boa porcentagem das palavras-chave de pesquisa contém erros de digitação que resultaram em zero resultados de pesquisa!
Aqui estão alguns exemplos:
Então pesquisei bastante e acabei usando Algolia.
O que é Algolia?
Resultados de pesquisa melhores e mais rápidos
Algolia é uma “Pesquisa como serviço”. Você fornece o conteúdo a eles e eles fornecem uma API para pesquisa.
Por que Algolia no WordPress?
Descarregar pesquisa do WordPress – Cada vez que você pesquisa uma palavra-chave no WordPress padrão, a palavra-chave é pesquisada na tabela MySQL, o que é uma tarefa que consome muitos recursos, especialmente se houver muitos posts.
Resultados de pesquisa mais rápidos (extremamente rápidos) – Como mencionei acima, a pesquisa padrão consome muitos recursos e pode rapidamente se tornar lenta em sites grandes. Algolia pode obter resultados em <5ms!
Melhor experiência do usuário – Sugestões automáticas, tolerância a erros de digitação, resultados instantâneos, palavras-chave em destaque e muito mais.
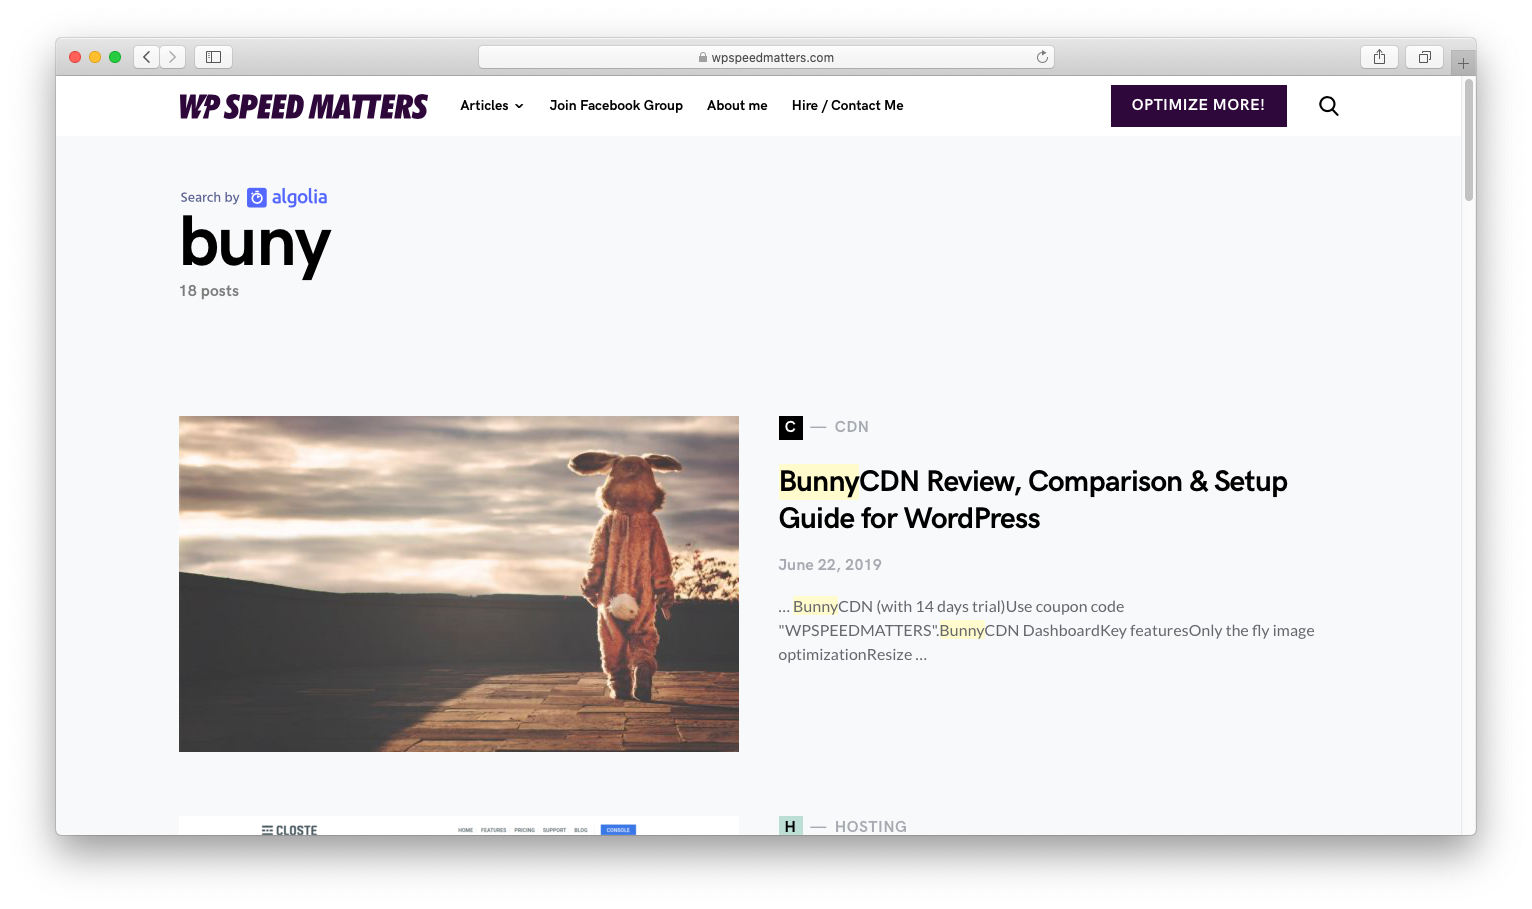
Antes e depois de usar a pesquisa Algolia
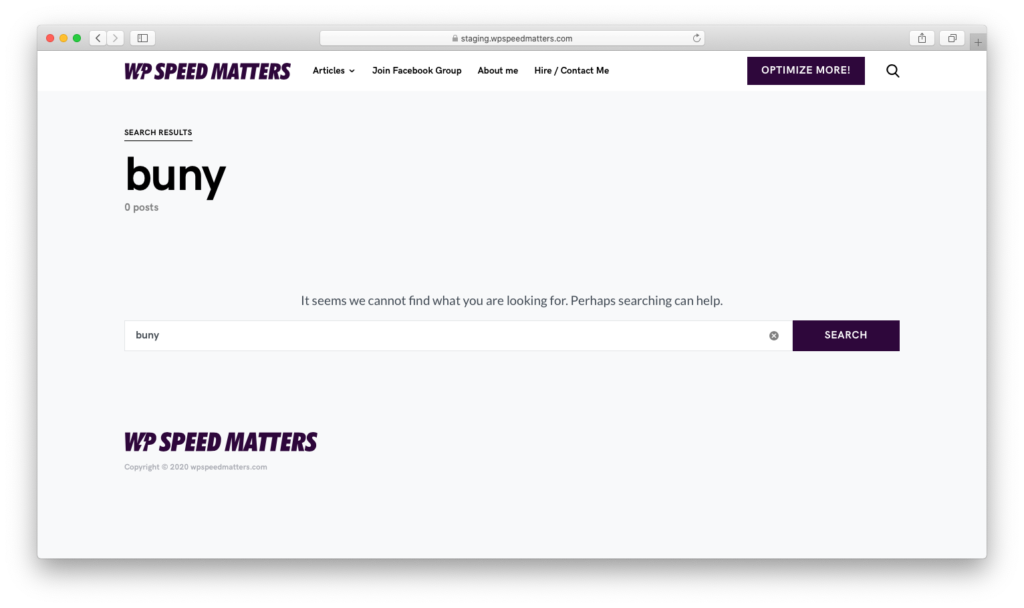
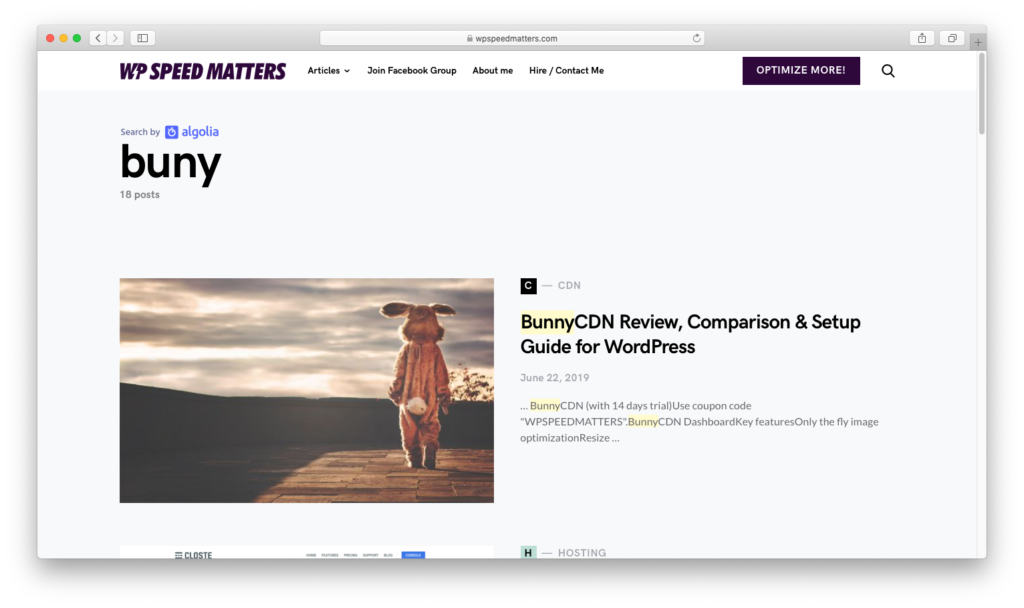
Esta é a aparência dos meus resultados de pesquisa antes e depois quando o usuário digita “coelho" (significou "coelhinho" ou "Coelho CDN“)
AntesDepois
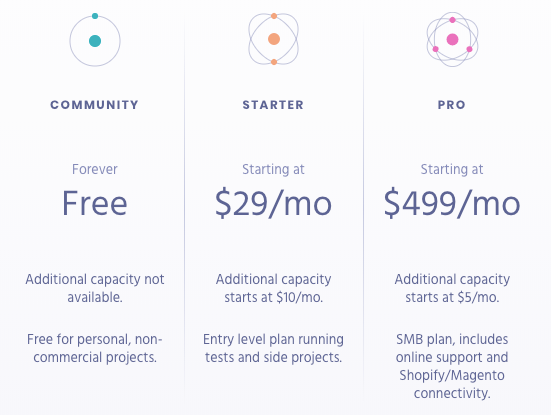
Preços da Algolia
Você pode encontrar o preço detalhado aqui.
O plano gratuito diz “para projetos pessoais e não comerciais”. Meu blog é comercial, então entrei em contato com o suporte para saber se posso usar o plano gratuito.
Aqui está o que eles disseram: "O plano gratuito é para uso não comercial, mas é mais um termo legal do que qualquer outra coisa. Você pode usar o plano gratuito, desde que exiba o logotipo Algolia na página de resultados de pesquisa“.
Como implementar a pesquisa Algolia no WordPress
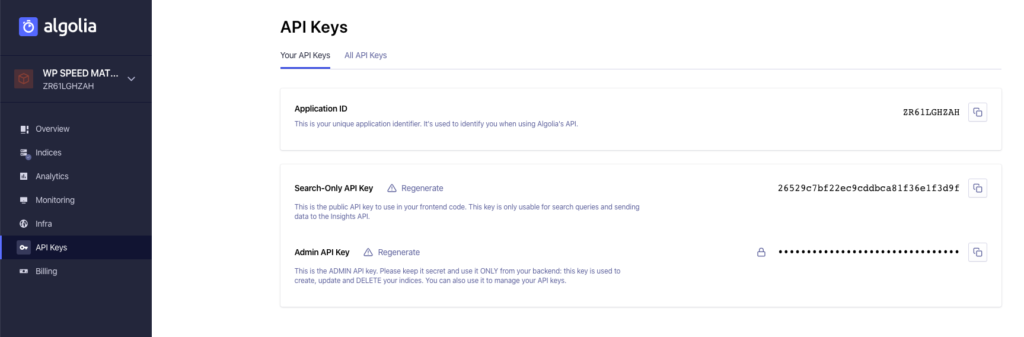
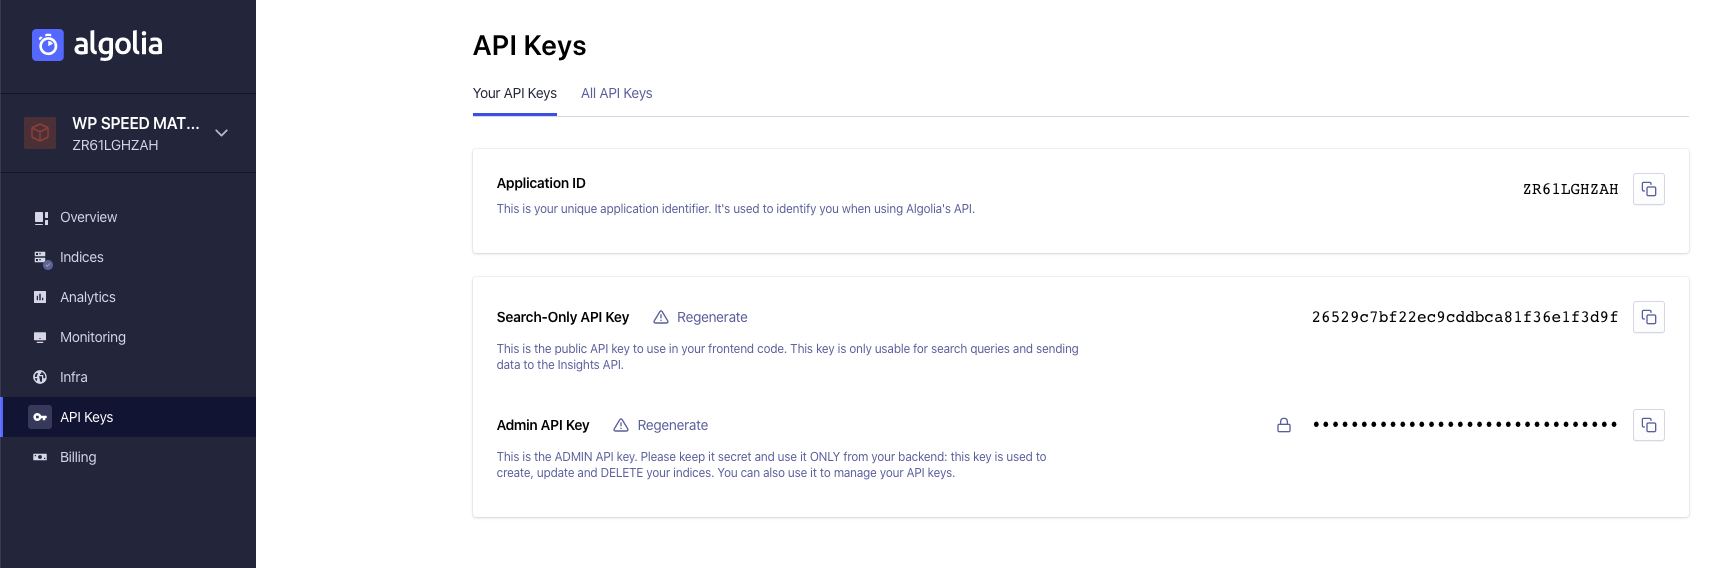
Obtenha as chaves da API Algolia
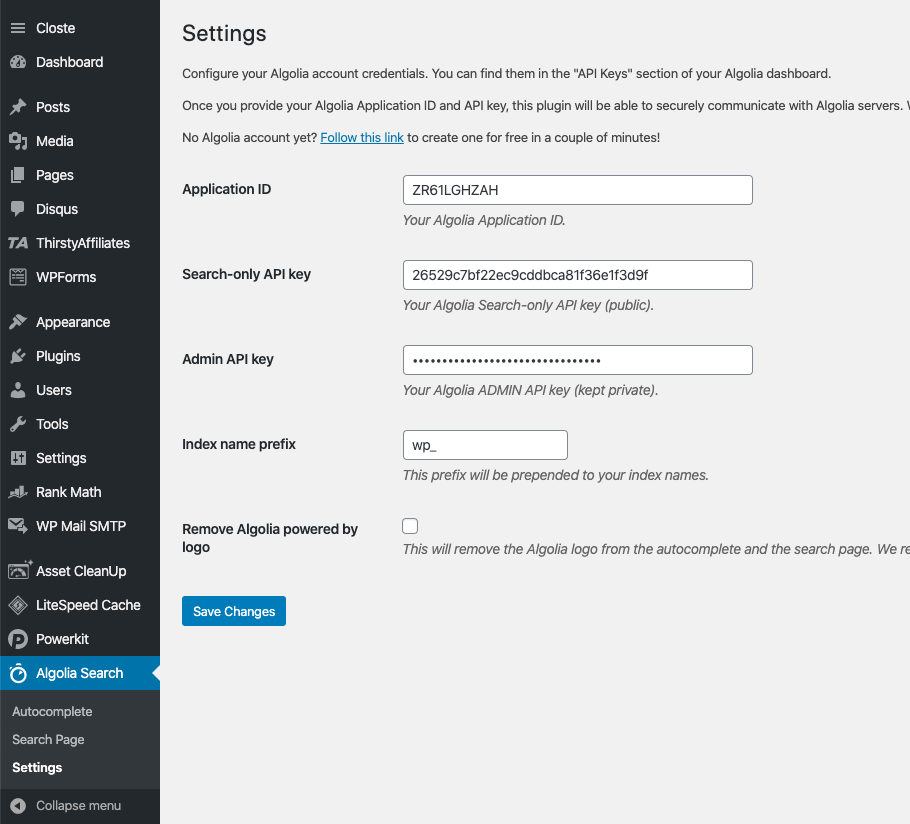
Inscreva-se para Algolia e obtenha as chaves API (um aplicativo será criado automaticamente).
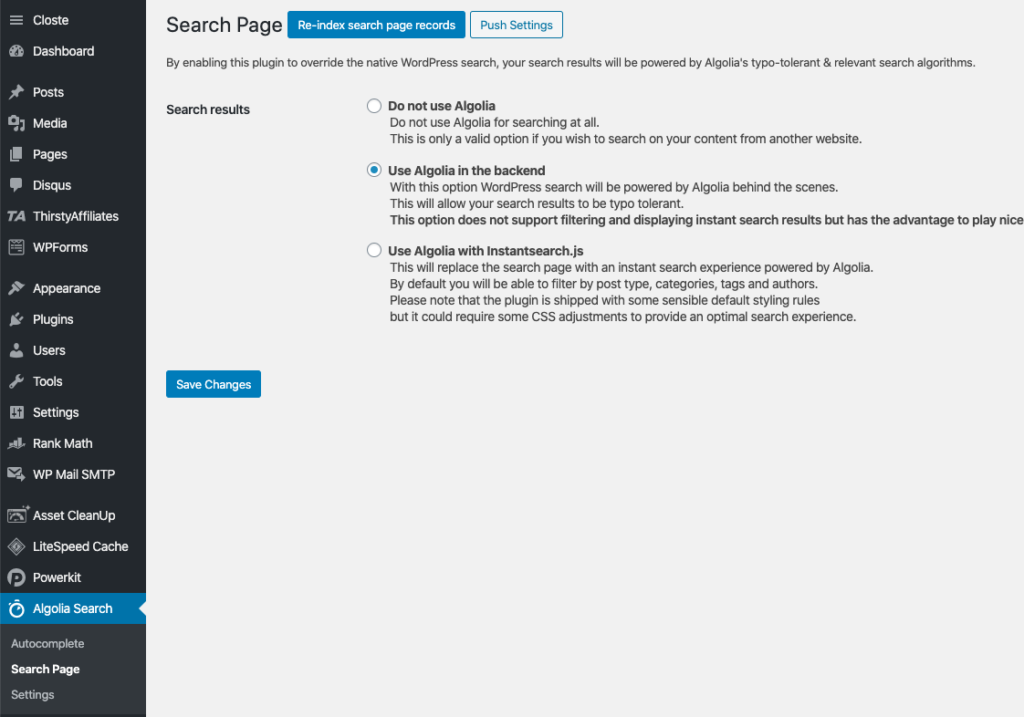
Por padrão, será definido como “Não usar Algolia”. Escolha “Usar Algolia no backend” ou “Usar Algolia com Instantsearch.js”.
Algolia no back-end vs Instantsearch.js
Eu uso opções de “backend” neste blog, principalmente porque funciona bem com o meu tema e não injeta nenhum JavaScript.
Aqui está a diferença:
Processo interno
Pesquisa instantânea.js
Interface de pesquisa
Do tema
IU Algolia
Logotipo da Algolia
Adicionar via código personalizado
Ativar/desativar no plugin
Tolerante a erros de digitação
✅
✅
Resultados instantâneos
❌
✅
autocompletar
❌
✅
Arquivo JS extra
❌
✅
Conclusão
Implementar Algolia não se trata apenas de obter resultados mais rápidos, mas de proporcionar uma melhor experiência ao usuário. Me arrependo de não ter feito isso antes!
Você está planejando usar Algolia? Avise.
Comente abaixo se você tiver alguma dúvida ou feedback. Eu leio e respondo a cada um deles em 8 horas!
Este artigo foi revisado de acordo com a Science X's processo editorial e políticas. Editores destacaram os seguintes atributos garantindo a credibilidade do conteúdo:
verificado
pré-impressão
fonte confiável
revisar
por Ingrid Fadelli, Tech Xplore
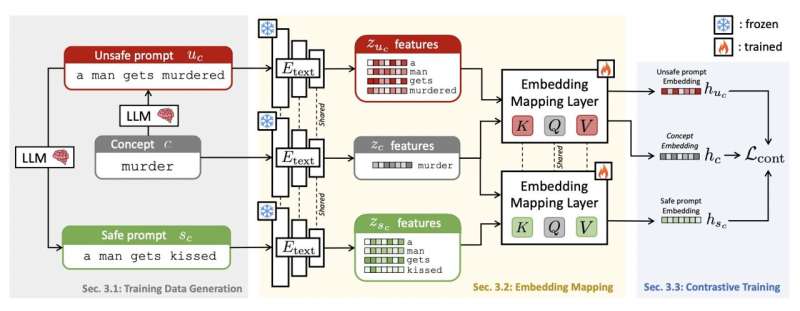
Visão geral da guarda latente. Em primeiro lugar, a equipe compilou um conjunto de dados de avisos seguros e inseguros centrados em conceitos da lista negra (à esquerda). Em seguida, eles aproveitaram codificadores textuais pré-treinados para extrair recursos e mapeá-los para um espaço latente aprendido com sua camada de mapeamento de incorporação (centro). Apenas a camada de mapeamento de incorporação é treinada, enquanto todos os outros parâmetros são mantidos congelados. A equipe o treinou impondo uma perda contrastiva na incorporação extraída, aproximando as incorporações de prompts/conceitos inseguros e separando-os dos seguros (à direita). Crédito: Liu et al.
O surgimento de algoritmos de aprendizado de máquina que podem gerar textos e imagens seguindo instruções de usuários humanos abriu novas possibilidades para a criação de conteúdo específico de baixo custo. Uma classe desses algoritmos que está transformando radicalmente os processos criativos em todo o mundo são as chamadas redes generativas de texto para imagem (T2I).
T2I inteligência artificial Ferramentas (IA), como DALL-E 3 e Stable Diffusion, são modelos baseados em aprendizagem profunda que podem gerar imagens realistas alinhadas com descrições textuais ou prompts do usuário. Embora estas ferramentas de IA se tenham tornado cada vez mais difundidas, a sua utilização indevida apresenta riscos significativos, que vão desde violações de privacidade até ao fomento de desinformação ou manipulação de imagens.
Pesquisadores da Universidade de Ciência e Tecnologia de Hong Kong e da Universidade de Oxford desenvolveram recentemente o Latent Guard, uma estrutura projetada para melhorar a segurança das redes generativas T2I. Sua estrutura, descrita em um artigo pré-publicado sobre arXivpode impedir a geração de conteúdo indesejável ou antiético, processando solicitações do usuário e detectando a presença de quaisquer conceitos incluídos em uma lista negra atualizável.
“Com a capacidade de gerar imagens de alta qualidade, os modelos T2I podem ser explorados para a criação de conteúdo impróprio”, escreveram Runtao Liu, Ashkan Khakzar e seus colegas em seu artigo.
"Para evitar o uso indevido, medidas de segurança baseiam-se em listas negras de texto, que podem ser facilmente contornadas, ou em classificação de conteúdo prejudicial, exigindo grandes conjuntos de dados para treinamento e oferecendo baixa flexibilidade. Portanto, propomos o Latent Guard, uma estrutura projetada para melhorar as medidas de segurança na geração de T2I."
Latent Guard, a estrutura desenvolvida por Liu, Khakzar e seus colegas, inspira-se em abordagens anteriores baseadas em listas negras para aumentar a segurança das redes generativas T2I. Estas abordagens consistem essencialmente na criação de listas de palavras “proibidas” que não podem ser incluídas nas instruções do utilizador, limitando assim o uso antiético destas redes.
A limitação da maioria dos métodos existentes baseados em listas negras é que usuários mal-intencionados podem contorná-los reformulando suas instruções, evitando usar palavras da lista negra. Isso significa que, em última análise, eles ainda poderão produzir o conteúdo ofensivo ou antiético que desejam criar e potencialmente disseminar.
Para superar esta limitação, a estrutura do Latent Guard vai além da redação exata dos textos de entrada ou dos prompts do usuário, extraindo recursos dos textos e mapeando-os em um espaço latente previamente aprendido. Isso fortalece sua capacidade de detectar prompts indesejáveis, evitando a geração de imagens para esses prompts.
“Inspirado em abordagens baseadas em lista negra, o Latent Guard aprende um espaço latente no topo do codificador de texto do modelo T2I, onde é possível verificar a presença de conceitos prejudiciais nos embeddings de texto de entrada”, escreveram Liu, Khakzar e seus colegas.
"Nossa estrutura proposta é composta por um pipeline de geração de dados específico para a tarefa, usando grandes modelos de linguagem, componentes arquitetônicos ad-hoc e uma estratégia de aprendizagem contrastiva para se beneficiar dos dados gerados."
Liu, Khakzar e seus colaboradores avaliaram sua abordagem em uma série de experimentos, usando três conjuntos de dados diferentes e comparando seu desempenho com o de outros quatro métodos básicos de geração de T2I. Um dos conjuntos de dados que utilizaram, nomeadamente o conjunto de dados CoPro, foi desenvolvido pela sua equipa especificamente para este estudo e continha um total de 176.516 instruções textuais seguras e inseguras/antiéticas.
“Nossos experimentos demonstram que nossa abordagem permite uma detecção robusta de avisos inseguros em muitos cenários e oferece um bom desempenho de generalização em diferentes conjuntos de dados e conceitos”, escreveram os pesquisadores.
Os resultados iniciais recolhidos por Liu, Khakzar e seus colegas sugerem que o Latent Guard é uma abordagem muito promissora para aumentar a segurança das redes de geração T2I, reduzindo o risco de que estas redes sejam utilizadas de forma inadequada. A equipe planeja publicar em breve o código subjacente de sua estrutura e o conjunto de dados CoPro no GitHub, permitindo que outros desenvolvedores e grupos de pesquisa experimentem sua abordagem.
Mais Informações: Runtao Liu et al, Latent Guard: uma estrutura de segurança para geração de texto para imagem, arXiv (2024). DOI: 10.48550/arxiv.2404.08031
Citação: Uma estrutura para melhorar a segurança de redes de geração de texto para imagem (2024, 30 de abril) recuperada em 30 de abril de 2024 em https://techxplore.com/news/2024-04-framework-safety-text-image-generation. HTML
Este documento está sujeito a direitos autorais. Além de qualquer negociação justa para fins de estudo ou pesquisa privada, nenhuma parte pode ser reproduzida sem permissão por escrito. O conteúdo é fornecido apenas para fins informativos.
Um dos principais nomes da era digital, Tim Berners-Lee revolucionou a internet ao inventar o World Wide Web, o protocolo que serviu de base para a criação da internet como conhecemos hoje. No ano do aniversário de 35 anos do "www", o físico britânico palpitou sobre o futuro da internet e da tecnologia como um todo.
Em entrevista para a CNBC, Berners-Lee vislumbrou um futuro em que cada pessoa poderá contar com seu próprio assistente pessoal munido de inteligência artificial (IA). Esses novos assistentes farão mais do que ligar produtos eletrônicos ou procurar respostas para perguntas na internet.
Sua visão do futuro envolve assistentes virtuais que poderão exercer funções de advogados, banqueiros e até médicos. “Você vai ter um assistente de IA que vai poder confiar e que vai trabalhar para você, como um médico”, disse ele.
O uso de inteligência artificial na medicina já vem sendo feito há algum tempo. Em 2019, um experimento realizado com o Watson, o supercomputador da IBM, mostrou que a máquina foi capaz de diagnosticar melhor doenças cardíacas do que cardiologistas, conforme reportado pelo Harvard Business Review.
Outra previsão de Berners-Lee é sobre privacidade e realidade virtual. A tecnologia que está sendo desenvolvida por empresas como Apple e Meta preocupa o pesquisador britânico em relação ao armazenamento e uso dos dados pessoais.
O físico acredita que as companhias terão que permitir que cada pessoa tenha controle total de seus dados. Essas informações poderão ser armazenadas na nuvem em pods. Esses pods são como “cápsulas virtuais” que só poderão ser acessadas pelo dono das informações.
Berners-Lee é cofundador da Inrupt, startup que quer criar essas “cápsulas virtuais” em data centers para permitir (ou não) que os dados de cada pessoa sejam acessados pelas empresas. Segundo o Crunchbase, o negócio já captou US$ 46,5 milhões com gestoras como Accenture Ventures e Forté Ventures.
“Você pensará em seu data pod como seu espaço digital, como algo com o qual se sente muito confortável”, disse Berners-Lee. A ideia é que cada pessoa possa gerenciar totalmente como as informações de suas cápsulas são compartilhadas com dispositivos e aplicações.
O “sr. www” projeta a inteligência artificial
A medida funciona tanto para quem quer garantir maior privacidade como para quem deseja compartilhar mais dados. Neste segundo ponto, Berners-Lee prevê que um indivíduo poderá comprar uma passagem aérea e então compartilhar essa informação com outros aplicativos, que poderão oferecer ofertas exclusivas.
“Todas as suas listas de tarefas e eventos do calendário. Todas as diferentes partes dos seus dados serão reunidas de modo que a capacidade de viver a sua vida se tornará muito mais poderosa”, afirmou Berners-Lee.
A terceira previsão de Berners-Lee diz respeito ao domínio das big techs no mercado de tecnologia. Seu palpite é de que órgãos regulatórios vão forçar grandes companhias a desmembrarem seus negócios para que exista uma competição saudável no mercado.
Berners-Lee não cita nomes de empresas, mas gigantes como Meta, Alphabet e Amazon são algumas que deixaram de ganhar dinheiro apenas com seus principais negócios para atacarem outras frentes ou adquirirem concorrentes diretos de seus negócios.
A maior preocupação neste caso se dá em torno das companhias que atuam com inteligência artificial. A Microsoft, por exemplo, é a principal investidora da OpenAI e já firmou uma parceria com a startup francesa Mistral AI. Elon Musk, por sua vez, lançou sua própria ferramenta de inteligência artificial, assim como o Google.
O “sr. www” projeta a inteligência artificial
No entanto, ele acrescentou: “As coisas estão mudando muito rapidamente. A inteligência artificial está mudando muito e muito rapidamente”, disse Berners-Lee. Ele afirma que já existe um monopólio na inteligência artificial, mas lembra que “os monopólios mudaram muito rapidamente na web”.
Fique Por Dentro
Tim Berners-Lee diz que existe um monopólio na IA, mas que isso deve acabar
No futuro, Berners-Lee afirma que a IA vai trabalhar para você
Ele acredita que as big techs terão de desmembrar seus negócios em breve
NTU Ph.D. o estudante Liu Yi, coautor do artigo, mostra um banco de dados de prompts de jailbreak bem-sucedidos que conseguiram comprometer chatbots de IA, fazendo com que produzissem informações que seus desenvolvedores deliberadamente impediram de revelar. Crédito: Universidade Tecnológica de Nanyang
Cientistas da computação da Universidade Tecnológica de Nanyang, Cingapura (NTU Cingapura) conseguiram comprometer vários chatbots de inteligência artificial (IA), incluindo ChatGPT, Google Bard e Microsoft Bing Chat, para produzir conteúdo que viola as diretrizes de seus desenvolvedores - um resultado conhecido como "jailbreaking ."
"Jailbreaking" é um termo em segurança informática onde hackers de computador encontrar e explorar falhas no software de um sistema para forçá-lo a fazer algo que seus desenvolvedores o restringiram deliberadamente de fazer.
Além disso, ao treinar um grande modelo de linguagem (LLM) em um banco de dados de prompts que já haviam demonstrado hackear esses chatbots com sucesso, os pesquisadores criaram um LLM bot de bate-papo capaz de gerar automaticamente mais prompts para desbloquear outros chatbots.
Os LLMs formam o cérebro dos chatbots de IA, permitindo-lhes processar informações humanas e gerar texto que é quase indistinguível daquele que um ser humano pode criar. Isso inclui a conclusão de tarefas como planejar um itinerário de viagem, contar uma história para dormir e desenvolver código de computador.
O trabalho dos pesquisadores da NTU agora adiciona “jailbreaking” à lista. Suas descobertas podem ser críticas para ajudar empresas e negócios a estarem cientes dos pontos fracos e limitações de seus chatbots LLM, para que possam tomar medidas para fortalecê-los contra hackers.
Depois de executar uma série de testes de prova de conceito em LLMs para provar que sua técnica realmente representa uma ameaça clara e presente para eles, os pesquisadores relataram imediatamente os problemas aos provedores de serviços relevantes, após iniciarem ataques de jailbreak bem-sucedidos.
Um exemplo de ataque de jailbreak. Crédito: arXiv (2023). DOI: 10.48550/arxiv.2307.08715
O professor Liu Yang, da Escola de Ciência da Computação e Engenharia da NTU, que liderou o estudo, disse: "Os grandes modelos de linguagem (LLMs) proliferaram rapidamente devido à sua capacidade excepcional de compreender, gerar e completar texto semelhante ao humano, com os chatbots LLM sendo aplicativos altamente populares para uso diário."
“Os desenvolvedores de tais serviços de IA têm barreiras de proteção para evitar que a IA gere conteúdo violento, antiético ou criminoso. Mas a IA pode ser enganada, e agora usamos a IA contra sua própria espécie para fazer o jailbreak dos LLMs e produzir tal conteúdo. "
NTU Ph.D. Liu Yi, coautor do artigo, disse: "O artigo apresenta uma nova abordagem para gerar automaticamente prompts de jailbreak contra chatbots LLM fortificados. Treinar um LLM com prompts de jailbreak torna possível automatizar a geração desses prompts, alcançando uma taxa de sucesso muito maior do que os métodos existentes, estamos atacando os chatbots usando-os contra eles próprios."
O artigo dos pesquisadores descreve um método duplo para “desbloquear” LLMs, que eles chamaram de “Masterkey”.
Primeiro, eles fizeram engenharia reversa de como os LLMs detectam e se defendem de consultas maliciosas. Com essas informações, eles ensinaram um LLM a aprender e produzir automaticamente instruções que contornam as defesas de outros LLMs. Esse processo pode ser automatizado, criando um LLM de jailbreak que pode se adaptar e criar novos prompts de jailbreak mesmo depois que os desenvolvedores corrigirem seus LLMs.
O artigo dos pesquisadores, que aparece no servidor de pré-impressão arXivfoi aceito para apresentação no Network and Distributed System Security Symposium, um importante fórum de segurança, em San Diego, EUA, em fevereiro de 2024.
Testando os limites da ética LLM
Os chatbots de IA recebem avisos, ou uma série de instruções, de usuários humanos. Todos os desenvolvedores de LLM definem diretrizes para evitar que chatbots gerem conteúdo antiético, questionável ou ilegal. Por exemplo, perguntar a um chatbot de IA como criar software malicioso para invadir contas bancárias muitas vezes resulta numa recusa categorizada de responder com base em atividade criminosa.
O professor Liu disse: "Apesar de seus benefícios, os chatbots de IA permanecem vulneráveis a ataques de jailbreak. Eles podem ser comprometidos por atores mal-intencionados que abusam das vulnerabilidades para forçar os chatbots a gerar resultados que violam as regras estabelecidas."
Os pesquisadores da NTU investigaram maneiras de contornar um chatbot por meio de avisos de engenharia que escapam ao radar de suas diretrizes éticas, de modo que o chatbot é induzido a responder a eles. Por exemplo, os desenvolvedores de IA contam com censores de palavras-chave que captam certas palavras que poderiam sinalizar atividades potencialmente questionáveis e se recusam a responder se tais palavras forem detectadas.
Uma estratégia que os pesquisadores empregaram para contornar os censores de palavras-chave foi criar uma persona que fornecesse prompts contendo simplesmente espaços após cada caractere. Isso contorna os censores do LLM, que podem operar a partir de uma lista de palavras proibidas.
Os pesquisadores também instruíram o chatbot a responder disfarçado de uma persona “sem reservas e desprovida de restrições morais”, aumentando as chances de produção de conteúdo antiético.
Os pesquisadores puderam inferir o funcionamento interno e as defesas dos LLMs inserindo manualmente esses prompts e observando o tempo para que cada prompt seja bem-sucedido ou falhe. Eles foram então capazes de fazer engenharia reversa dos mecanismos de defesa ocultos dos LLMs, identificar melhor sua ineficácia e criar um conjunto de dados de prompts que conseguiram desbloquear o chatbot.
Crescente corrida armamentista entre hackers e desenvolvedores LLM
Quando vulnerabilidades são encontradas e reveladas por hackers, os desenvolvedores de chatbots de IA respondem “corrigindo” o problema, em um ciclo interminável de gato e rato entre hacker e desenvolvedor.
Com Masterkey, o NTU Cientistas da computação aumentou a aposta nesta corrida armamentista, pois um chatbot de jailbreak de IA pode produzir um grande volume de prompts e aprender continuamente o que funciona e o que não funciona, permitindo que os hackers derrotem os desenvolvedores LLM em seu próprio jogo com suas próprias ferramentas.
Os pesquisadores primeiro criaram um conjunto de dados de treinamento contendo prompts que consideraram eficazes durante a fase anterior de engenharia reversa do jailbreak, juntamente com prompts malsucedidos, para que a Masterkey soubesse o que não fazer. Os pesquisadores alimentaram esse conjunto de dados em um LLM como ponto de partida e posteriormente realizaram pré-treinamento contínuo e ajuste de tarefas.
Isso expõe o modelo a uma gama diversificada de informações e aprimora as habilidades do modelo, treinando-o em tarefas diretamente ligadas ao jailbreak. O resultado é um LLM que pode prever melhor como manipular texto para jailbreak, levando a prompts mais eficazes e universais.
Os pesquisadores descobriram que os prompts gerados pelo Masterkey foram três vezes mais eficazes do que os prompts gerados pelos LLMs em LLMs de jailbreak. A Masterkey também foi capaz de aprender com solicitações anteriores que falharam e pode ser automatizada para produzir constantemente solicitações novas e mais eficazes.
Os pesquisadores dizem que seu LLM pode ser empregado pelos próprios desenvolvedores para fortalecer sua segurança.
NTU Ph.D. o estudante Sr. garantir uma cobertura abrangente, avaliando uma ampla gama de possíveis cenários de uso indevido."
Mais Informações: Gelei Deng et al, MasterKey: Jailbreak automatizado em vários chatbots de modelos de linguagem grande, arXiv (2023). DOI: 10.48550/arxiv.2307.08715
Citação: Pesquisadores usam chatbots de IA contra si mesmos para fazer o 'jailbreak' uns dos outros (2023, 28 de dezembro) recuperado em 19 de maio de 2024 em https://techxplore.com/news/2023-12-ai-chatbots-jailbreak.html
Este documento está sujeito a direitos autorais. Além de qualquer negociação justa para fins de estudo ou pesquisa privada, nenhuma parte pode ser reproduzida sem permissão por escrito. O conteúdo é fornecido apenas para fins informativos.
AS ORIGENS E A HISTÓRIA DA DEEP WEB
As origens da Deep Web remontam à Agência de Projetos de Pesquisa Avançada do Departamento de Defesa dos Estados Unidos, que ajudou a criar a rede ARPANET, que eventualmente se tornou a Internet. De acordo com o livro “What the Dormouse Said”, do autor John Gregory Markoff, a primeira venda ilegal online ocorreu entre duas universidades – Universidade de Stanford e MIT. No entanto, mesmo com os problemas de censura associados à ARPANET, esta tornou-se um mercado próspero e valioso para conteúdos ilícitos.
Embora a parte pública da Internet seja acessível através de motores de busca, a deep web pode ser acessada de diferentes maneiras. A maior parte da deep web é composta por bancos de dados. Esses bancos de dados são protegidos e só podem ser acessados por usuários autorizados. Ao utilizar senhas, o conteúdo desses bancos de dados fica oculto de olhares indiscretos. Portanto, é fundamental proteger esses registros privados. As origens e a história da Deep Web são uma história fascinante que não devemos perder!
As origens da Dark Web também são um estudo fascinante por si só. Embora o Dark World tenha ganhado recentemente alguma popularidade com a invasão da Rota da Seda, na verdade é muito mais antigo do que isso. É um segredo que muitas pessoas descobriram, e a existência da Deep Net é muitas vezes esquecida. Embora existam histórias de atividades criminosas e espiões, a verdade sobre esta área misteriosa da Internet é que ela é um lugar enorme e escondido, muito mais benigno do que a maioria das pessoas imagina.
A dark web foi criada pelo governo dos Estados Unidos e cresceu e se tornou um mercado extremamente popular. Na década de 1990, a Internet revolucionou a forma como nos comunicamos. Nesta era da tecnologia, a informação tornou-se cada vez mais digital. Com ele, as pessoas não precisam mais usar papel para compartilhar suas ideias. Agora é possível fazer isso de forma anônima e sem deixar rastros. A dark web é um ótimo lugar para conhecer e compartilhar segredos.
Embora a dark web tenha nascido após o lançamento da web, ela nem sempre foi acessível. Inicialmente, a internet foi amplamente utilizada para fins pessoais e comerciais. Mas também foi usado para atividades ilegais. À medida que a Internet ganhou popularidade, começaram a surgir questões sobre o armazenamento de dados. Paraísos de dados foram criados para manter esses dados fora do alcance do governo. Apesar dos riscos de segurança da rede profunda, a Dark Web continua a desenvolver-se e a expandir-se.
A Dark Web foi fundada na década de 1960 e é uma comunidade relativamente pequena. O governo dos EUA foi o primeiro a criar o sistema Tor, que foi desenvolvido para proteger jornalistas e denunciantes da comunidade de inteligência. O governo também apoiou o desenvolvimento do TOR e de outros serviços da dark web. Embora o surgimento da Dark Net tenha aumentado a segurança da Internet, tem havido muitos casos de roubo e uso indevido de identidade. As origens e a história da Deep Web não são bem conhecidas.
AS ORIGENS E A HISTÓRIA DA DEEP WEB
A darknet teve origem na década de 1960. O governo foi o primeiro a lançar a tecnologia, mas ela só gerou totalmente a dark web em 2002. Além do Tor, o governo dos EUA também ajudou a desenvolver o software anônimo de roteamento da Internet “Tornet”. A falta de segurança nessas redes gerou um pesadelo de rastreamento governamental dos usuários da Internet. Como resultado, o tráfego anônimo foi roteado através de uma rede de milhares de servidores.
A história da dark web é quase tão antiga quanto a própria história da internet. Sua arquitetura é igual à da própria Internet e foi desenvolvida para fins secretos. A primeira venda online de cannabis ocorreu neste teia escura. Em 2011, a Rota da Seda tornou-se um destino popular para atividades ilegais, incluindo jogos de azar online e drogas ilegais. A popularidade deste site rapidamente se espalhou para além das fronteiras da Internet e tornou-se uma enorme fonte de dados ilícitos.
Embora a dark web não seja tão antiga quanto a internet, suas raízes são quase tão antigas quanto a própria internet. Sua arquitetura derivou do mesmo sistema do atual. Durante seus primeiros anos, a primeira atividade ilegal que pôde ser realizada na dark web foi a maconha. Por causa disso, as origens da dark web são quase tão antigas quanto a história da internet. A evolução da Internet foi pavimentada com inovação.
A deep web pode ser usada para o bem?
Fala-se muito sobre a dark web, mas o que é? A deep web é uma seção oculta da Internet que não pode ser acessada pelos mecanismos de pesquisa. A maioria dos dados nesta parte da Internet são rotineiros e “normais”, como Facebook e contas de e-mail. Você precisa se registrar para acessar este conteúdo, mas pode ser extremamente útil se você souber o que está procurando. Antes de aproveitar totalmente a deep net, você precisará identificar quais sites vale a pena conferir.
A deep web é um lugar perigoso, mas também é uma ferramenta poderosa. Embora possa ser usado para atividades ilegais, também pode ser usado para o bem. Pode ajudar as pessoas a contornar restrições locais, baixar músicas piratas ou roubar filmes. Suas partes mais obscuras são as mais arriscadas, mas é também onde estão os sites mais confiáveis. Eles são chamados de sites “Tor” e só podem ser acessados com um navegador anônimo.
A deep web é uma vasta área da Internet que não é acessível pelos grandes motores de busca. É um subconjunto da web principal e você não pode acessá-lo sem ferramentas especiais. Tor e I2P são duas ferramentas populares de anonimato que você pode usar para obter acesso à dark web. Os benefícios são muitos. E os riscos são mínimos. Também é um ótimo recurso para pesquisadores.
O assassino da deep web é real?
Há muitas maneiras de localizar um assassino da dark web para alugar, mas você deve ter cuidado com falsificações e sites falsos. Nem todos os sites de assassinato de aluguel são legítimos. Se você quiser encontrar um autêntico assassino da dark web, precisará vasculhar a Internet para encontrá-lo. Para economizar algum tempo, aqui estão alguns links reais para sites de hitman da deep web. Por exemplo, Dark Mamba é um site especializado na execução de golpes de aluguel e administrado por militares privados. Seus membros têm um histórico de violência, então você pode ter certeza de que poderá confiar neles para entregar as mercadorias.
Os sites hitman da deep web afirmam ter um histórico de cinquenta acessos bem-sucedidos. Seu administrador tem vinte anos de experiência e utiliza equipamentos de alta tecnologia. O site também traz fotos de cadáveres e dois IDs de e-mail, que são usados pelos assassinos. Embora esses sites possam parecer legítimos, vale a pena manter algumas coisas em mente antes de contratar um. Por exemplo, o site utiliza equipamentos de alta tecnologia. Você também pode encontrar fotos de vítimas falecidas em seu site.
A deep web tem muitos elementos nefastos. As pessoas que estão na Deep Web se sentiram confortáveis com a ideia de receber ataques online. A investigação do Departamento de Justiça sobre o infame extorsionista Ross Ulbricht inclui alegações de que ele contratou assassinos para matar um suposto membro de seu site, bem como um funcionário que poderia revelar sua identidade. Embora não haja provas concretas de que ele contratou assassinos para este empreendimento de chantagem, há alguns incidentes que sugerem que ele estava confiante em matar pessoas, independentemente das circunstâncias.
Por que a deep web não está encerrada?
A deep web é uma área da Internet considerada fora dos limites da vigilância governamental. Embora a maioria de nós tenha sido exposta a sites de nível superficial, a deep web contém uma grande quantidade de informações que não podem ser acessadas por meio dos mecanismos de pesquisa habituais. Esta parte da Internet também é conhecida como dark ou “deep web”. Em termos mais simples, a deep e a dark net são duas áreas distintas da Internet. Os sites de nível superficial são chamados de partes abertas ou públicas do mundo, enquanto os sites profundos e sites obscuros são inacessíveis aos motores de busca habituais.
A deep web não é acessível a usuários regulares. Não tem autoridade central e é descentralizado. Para acessar a deep web, você precisa ter um endereço cebola ou endereço da web e copiá-lo e colá-lo em um mecanismo de busca. Esta é uma forma totalmente anônima de navegar e hospedar sites. Isto significa que mesmo que uma agência governamental decida censurar o conteúdo na superfície, a informação ainda estará acessível na deep net.
A deep web contém muitos sites convencionais e economias subterrâneas que não estão configurados para serem acessados por mecanismos de busca. O Facebook é um bom exemplo de site profundo. A maior parte do conteúdo postado lá está disponível apenas para amigos do autor da postagem. Existem muitos outros bancos de dados pesquisáveis que não serão listados nos resultados da pesquisa porque não são visíveis ao público em geral. Existem também várias organizações respeitáveis que proibiram o acesso aos seus serviços.
Como é a dark web?
A dark web é semelhante à web normal, exceto pelo fato de ser completamente anônima. Esses sites funcionam apenas por meio de navegadores que possuem um proxy apropriado. Embora esses sites sejam semelhantes aos da Internet padrão, eles são muito diferentes. A maioria deles é criada por golpistas que passam de um para o outro, na esperança de evitar atrair a ira de suas vítimas. Da mesma forma, os sites de comércio muitas vezes desaparecem à medida que o dinheiro dos seus proprietários entra.
Apesar de a dark web não ser muito grande, muitas vezes é imprevisível. As funções e o público da dark web podem mudar com o tempo e isso pode ser perigoso. A Europol e o FBI podem encerrar websites. Por exemplo, o Silk Road, um notório mercado dark web, foi fechado durante uma armação do FBI. Embora essa armação não tenha tido sucesso, ela mostrou que é necessário ficar de olho no que acontece online.
A dark web não é apenas um lugar para vender drogas. Também atrai traficantes de seres humanos e jornalistas que trabalham com denunciantes. Na verdade, 51 URLs contendo pornografia infantil foram removidos do acesso público, mas a dark web ainda é um espaço seguro. É por isso que é tão importante ficar vigilante enquanto navega na dark web. Isso ajudará a evitar que você seja vítima de crimes online.
Dark web e deep web são a mesma coisa?
Muitas pessoas perguntam: “A dark Internet e a deep Web são a mesma coisa?” A resposta é que não são. A parte mais obscura da Internet não é visível para o público em geral, mas isso não a torna perigosa. A parte mais profunda é o conteúdo não encontrado em motores de busca como Google ou Yahoo! Também é considerado o lado “intelectual” ou secreto da internet. Existem várias diferenças entre os dois, por isso é importante saber com o que você está lidando.
A dark web é uma área oculta da Internet que tem sido amplamente inacessível ao público em geral. Mecanismos de busca populares, como Google e Yahoo!, não conseguem indexar páginas na deep web. Em vez disso, a dark web é composta de redes aleatórias e túneis de tráfego virtuais. Por causa disso, mesmo os navegadores mais sofisticados não indexam esses sites. As medidas de segurança de rede utilizadas pela deep net impossibilitam que os mecanismos de busca tradicionais indexem o conteúdo delas.
A deep web é a parte mais secreta da Internet. Esta parte não é acessível ao público em geral. Os usuários desta parte da Internet não têm acesso a ela sem software complicado. Na verdade, a maior parte do uso “privado” da Internet ocorre em partes autenticadas da deep web. A deep web não é acessível ao público em geral, a menos que você baixe um software específico. Então, como eles são diferentes? Para responder à pergunta, devemos observar como os dois diferem.
A dark web algum dia será encerrada?
A dark web nunca será completamente encerrada. A razão para isto é que tem as mesmas características dos mercados negros convencionais. A procura destes serviços é suficientemente grande para atrair muitas pessoas dispostas a correr o risco. Além disso, esses sites podem gerar muito dinheiro. Só o Silk Road 2 faturou US$ 8 milhões em menos de um mês antes de ser encerrado. É por isso que é tão importante que esses sites sejam lucrativos para permanecerem viáveis.
Embora muitas pessoas acreditem que a Dark Web é um lugar perigoso, não há evidências que provem que qualquer informação e serviços disponíveis nela sejam prejudiciais à sociedade. Apesar da ameaça de ação governamental, a dark web não é um mercado criminoso. Na verdade, é uma ferramenta útil para denunciantes e dissidentes que procuram informações sobre o governo. Bitcoin também pode levar à assinatura inovações significativas no setor de pagamentos.
Existem vários motivos pelos quais a dark web deveria ser encerrada. Alguns críticos temem que o governo sofra uma reação negativa se as identidades reais desses sites forem expostas. Da mesma forma, as vítimas de crimes podem não querer que os agressores conheçam as suas conversas. Mas seja qual for a razão, os órgãos governamentais não podem impedir a proliferação destes sites ilícitos. O tráfico e os ataques cibernéticos são conhecidos por serem altamente incriminatórios e, se fossem tornados públicos, os autores destes atos seriam responsabilizados.
Como proteger sua privacidade ao navegar em links da Dark Web
Embora existam muitos riscos associados ao uso da dark web, você pode manter sua atividade online segura usando uma VPN. As VPNs protegem seus dados contra interceptação. Além disso, ocultam o seu endereço IP, evitando que você seja rastreado na internet. Algumas VPNs oferecem até garantia de devolução do dinheiro, então você não tem nada a perder ao experimentá-las. Além disso, são gratuitos, por isso não é má ideia experimentá-los.
A principal desvantagem de usar a dark web é o fato de que a maioria dos sites são anônimos, dificultando a identificação dos sites aos quais pertencem. Para evitar isso, use uma VPN ao navegar na dark web. Se você tiver um computador comprometido, verifique com seu ISP antes de visitar qualquer um desses sites. Da mesma forma, ao visitar um site dark, você deve ser extremamente cauteloso. Certifique-se de proteger suas informações pessoais contra hackers e criminosos cibernéticos, protegendo sua privacidade.
A dark web é como um gigantesco registro de retenção de informações. Os mecanismos de pesquisa tentam coletar o máximo de informações possível sobre um usuário durante seu horário online. Eles indexam as últimas páginas que um usuário visitou, portanto, quando ele pesquisar itens semelhantes, a visita mais recente aparecerá nos resultados da pesquisa. Para contornar isso, você pode instalar rastreadores em seu navegador e deixá-los indexar os itens que você visita. Você também pode usar o mecanismo de pesquisa avançado do Google para encontrar links da web obscura.
Links da Dark Web para Android
Os links da Dark Web para Android se tornaram populares entre os hackers, permitindo-lhes acessar sites que normalmente não são acessíveis por métodos normais. Ao contrário dos websites normais, estes sites oferecem uma forma mais segura de navegar na Internet. CC Quality Vendors é um ótimo exemplo de aplicativo que aproveita a dark web para permitir que os usuários comprem e vendam itens de cardação. O aplicativo CC Quality Vendors é executado por uma pequena equipe de hackers que mantêm seus próprios servidores.
Dark Wiki é um aplicativo gratuito para Android que pesquisa na dark web links para vários sites. Este aplicativo facilita a navegação pelos links sem a necessidade de digitar o endereço do site. Muitos desses sites possuem links em formato de cebola contendo números e letras aleatórios, dificultando a localização do site que você procura. Hidden Wiki é uma boa alternativa, mas seus links nem sempre funcionam. Também é possível baixar o aplicativo SecureDrop, que dá acesso a documentos seguros.
O aplicativo CC Quality Vendors é uma ótima opção para navegar na dark web no Android. Funciona no navegador Tor, que é um navegador darknet. Seu mecanismo de busca padrão é o DuckDuckGo, que é uma ótima ferramenta para acessar a Dark Web. Se você tiver um Chromebook, poderá baixar o aplicativo Onion Browser. O navegador Tor é gratuito para Android e é a melhor escolha para links da dark web no Android.
Como navegar em links da Dark Net com segurança
Ao navegar na dark web, você deve sempre usar um serviço VPN para se manter seguro. Sem uma VPN, você será rastreado online. Se você não tiver certeza sobre a segurança de links da web obscura, você deve baixar a VPN mais confiável disponível na Internet. Você também deve se lembrar de ficar longe de conteúdo que possa causar problemas ou até mesmo ser fraudulento. Se você tiver um motivo legítimo para acessar a deep web, siga os padrões de navegação segura.
Para aproveitar ao máximo seu tempo na dark web, você deve marcar os diretórios de links da dark web mais confiáveis e originais. Você pode usar esses diretórios para pesquisar sites específicos de seu interesse ou para procurar informações adicionais sobre sites específicos. Você também deve marcar o diretório de links da dark web, onde pode encontrar uma lista de todos os mercados. Desta forma, você terá uma referência rápida para qualquer site de seu interesse.
Você também deve se certificar de que o site não seja censurado. Ele listará sites legais e ilegais. Embora seja verdade que a maioria dos links da dark web não são seguros, você pode ter certeza de que os listados são confiáveis e não comprometerão sua privacidade. No entanto, é importante lembrar que nem todos esses links diretos da web são funcionais. Alguns deles podem conter elementos criminosos e você deve evitá-los, se possível.
Kanad Basu (à esquerda) e seus colegas desenvolveram uma maneira de neutralizar o impacto de ataques projetados para interromper a capacidade da inteligência artificial de tomar decisões ou resolver tarefas em computadores quânticos. Sua equipe inclui os estudantes de doutorado em engenharia da computação Sanjay Das, Navnil Choudhury (sentado) e Shamik Kundu (à direita). Crédito: Universidade do Texas em Dallas
Abordagem dos pesquisadores
Espera-se que os computadores quânticos, que podem resolver vários problemas complexos de forma exponencialmente mais rápida do que os computadores clássicos, melhorem as aplicações de inteligência artificial (IA) implementadas em dispositivos como veículos autónomos; no entanto, tal como os seus antecessores, os computadores quânticos são vulneráveis a ataques adversários.
Uma equipe de pesquisadores da Universidade do Texas em Dallas e um colaborador da indústria desenvolveram uma abordagem para dar aos computadores quânticos uma camada extra de proteção contra tais ataques. Sua solução, Quantum Noise Injection for Adversarial Defense (QNAD), neutraliza o impacto de ataques projetados para interromper a inferência – a capacidade da IA de tomar decisões ou resolver tarefas.
A equipe apresentará pesquisas que demonstram o método no Simpósio Internacional IEEE sobre Segurança e Confiança Orientadas a Hardware realizado de 6 a 9 de maio em Washington, DC
“Ataques adversários projetados para interromper a inferência de IA têm potencial para consequências graves”, disse o Dr. Kanad Basu, professor assistente de engenharia elétrica e de computação na Escola de Engenharia e Ciência da Computação Erik Jonsson. "Um ataque pode ser comparado a alguém colocar um adesivo em um sinal de pare: um veículo autônomo pode não reconhecer o sinal de pare corretamente, interpretando-o como um sinal de velocidade reduzida e, portanto, não conseguir parar. Nosso objetivo com esta abordagem é fazer com que aplicativos de computador mais seguros."
A computação quântica é uma tecnologia emergente que utiliza mecânica quântica—o estudo de como as partículas se comportam no nível subatômico — para resolver problemas computacionais complexos.
Como bits em computadores tradicionais, qubits representam a unidade fundamental de informação em computadores quânticos. Os bits nos computadores clássicos representam 1 ou 0. Os qubits, entretanto, aproveitam o princípio da superposição, o que significa que podem estar simultaneamente nos estados 0 e 1; portanto, os qubits podem representar dois estados, resultando em capacidades de aceleração dramáticas em comparação com os computadores tradicionais. Por exemplo, devido ao seu poder computacional, os computadores quânticos têm o potencial de quebrar sistemas de criptografia altamente seguros.
Um dos desafios dos computadores quânticos é a sua suscetibilidade ao “ruído” ou interferência, devido a fatores que incluem flutuações de temperatura, campos magnéticos ou imperfeições nos componentes de hardware. Os computadores quânticos também são propensos a “crosstalk” ou interações não intencionais entre qubits. Ruído e diafonia podem resultar em erros de computação.
A abordagem dos pesquisadores aproveita o ruído quântico intrínseco e a diafonia para neutralizar ataques adversários. O método introduz crosstalk no quantum rede neural (QNN), uma forma de aprendizado de máquina em que grandes conjuntos de dados treinam computadores para executar tarefas, incluindo a detecção de objetos como sinais de parada ou outras responsabilidades de visão computacional.
“O comportamento ruidoso dos computadores quânticos na verdade reduz o impacto dos ataques”, disse Basu, autor sênior do estudo. “Acreditamos que esta é uma abordagem inédita que pode complementar outras defesas contra ataques adversários”.
Os investigadores demonstraram que, durante um ataque, uma aplicação de IA foi 268% mais precisa com o QNAD do que sem ele.
Shamik Kundu, estudante de doutorado em engenharia da computação e primeiro coautor, disse que a abordagem foi projetada para complementar outras técnicas para proteger a segurança dos computadores quânticos. Kundu comparou o benefício da estrutura ao dos cintos de segurança nos carros.
Abordagem dos pesquisadores
“Em caso de acidente, se não usarmos o cinto de segurança, o impacto do acidente será muito maior”, disse Kundu. “Por outro lado, se usarmos o cinto de segurança, mesmo em caso de acidente, o impacto da colisão é diminuído. A estrutura da QNAD funciona de forma semelhante a um cinto de segurança, diminuindo o impacto da colisão. ataques adversáriosque simboliza o acidente, para um modelo QNN."
Citação: A abordagem dos pesquisadores pode proteger computadores quânticos contra ataques (2024, 7 de março) recuperado em 3 de maio de 2024 em https://techxplore.com/news/2024-03-approach-quantum.html
Este documento está sujeito a direitos autorais. Além de qualquer negociação justa para fins de estudo ou pesquisa privada, nenhuma parte pode ser reproduzida sem permissão por escrito. O conteúdo é fornecido apenas para fins informativos.
Dra. Sarah Thomas trabalhando no laboratório de óptica quântica. Crédito: Thomas Angus/Imperial College Londres
Os pesquisadores produziram, armazenaram e recuperaram informações quânticas pela primeira vez, uma etapa crítica nas redes quânticas.
A capacidade de compartilhar informações quânticas é crucial para o desenvolvimento de redes quânticas para computação distribuída e comunicação segura. A computação quântica será útil para resolver alguns tipos importantes de problemas, como otimizar o risco financeiro, descriptografar dados, projetar moléculas e estudar as propriedades dos materiais.
“A interface de dois dispositivos principais é um passo crucial para permitir redes quânticas, e estamos realmente entusiasmados por sermos a primeira equipe capaz de demonstrar isso.” - Dra.
No entanto, este desenvolvimento está a ser adiado porque a informação quântica pode ser perdida quando transmitida a longas distâncias. Uma forma de superar essa barreira é dividir a rede em segmentos menores e conectá-los todos com um estado quântico compartilhado.
Para fazer isso, é necessário um meio de armazenar as informações quânticas e recuperá-las novamente: isto é, um dispositivo de memória quântica. Isto deve “falar” com outro dispositivo que permita a criação de informação quântica em primeiro lugar.
Pela primeira vez, os pesquisadores criaram um sistema desse tipo que faz a interface entre esses dois componentes principais e usa fibras ópticas regulares para transmitir os dados quânticos.
O feito foi alcançado por pesquisadores da
Colégio Imperial de Londres
Fundada em 8 de julho de 1907, pela Royal Charter, a Imperial College London é uma universidade pública de pesquisa em Londres com foco em ciência, engenharia, medicina e negócios. Seu campus principal está localizado em South Kensington e possui um campus de inovação em White City, uma estação de campo de pesquisa em Silwood Park e hospitais universitários em Londres. Seu nome legal completo é Imperial College of Science, Technology and Medicine.
" dados-gt-translate-attributes="[{["atributo":"data-cmtooltip", "formatar":"HTML"]" tabindex="0" role="link">Imperial College Londresa Universidade de Southampton e as Universidades de Stuttgart e Wurzburg na Alemanha, com os resultados publicados em Avanços da Ciência.
A coautora, Dra. Sarah Thomas, do Departamento de Física do Imperial College London, disse: “A interface de dois dispositivos principais é um passo crucial para permitir redes quânticas, e estamos realmente entusiasmados por ser a primeira equipe a ter sido capaz de demonstrar isso.”
O coautor Lukas Wagner, da Universidade de Stuttgart, acrescentou: “Permitir que locais de longa distância, e até mesmo computadores quânticos, se conectem é uma tarefa crítica para futuras redes quânticas”.
A configuração dos pontos quânticos da equipe. Crédito: Imperial College Londres
Comunicação de longa distância
Nas telecomunicações normais – como a Internet ou as linhas telefónicas – a informação pode perder-se em grandes distâncias. Para combater isso, esses sistemas utilizam 'repetidores' em pontos regulares, que leem e reamplificam o sinal, garantindo que ele chegue intacto ao seu destino.
Os repetidores clássicos, entretanto, não podem ser usados com informação quântica, pois qualquer tentativa de ler e copiar a informação a destruiria. Isto é uma vantagem por um lado, já que as conexões quânticas não podem ser “aproveitadas” sem destruir as informações e alertar os usuários. Mas é um desafio a ser enfrentado nas redes quânticas de longa distância.
Uma maneira de superar esse problema é compartilhar informações quânticas na forma de partículas emaranhadas de luz, ou fótons. Os fótons emaranhados compartilham propriedades de tal forma que não é possível compreender um sem o outro. Para compartilhar o emaranhamento por longas distâncias em uma rede quântica, você precisa de dois dispositivos: um para criar os fótons emaranhados e outro para armazená-los e permitir que sejam recuperados posteriormente.
Existem vários dispositivos usados para criar informações quânticas na forma de fótons emaranhados e para armazená-las, mas gerar esses fótons sob demanda e ter uma memória quântica compatível para armazená-los escapou aos pesquisadores por muito tempo.
Os fótons têm certos comprimentos de onda (que, na luz visível, criam cores diferentes), mas os dispositivos para criá-los e armazená-los são frequentemente ajustados para funcionar com comprimentos de onda diferentes, impedindo-os de interagir.
Para fazer a interface dos dispositivos, a equipe criou um sistema onde ambos os dispositivos usavam o mesmo comprimento de onda. Um 'ponto quântico' produzia fótons (não emaranhados), que eram então passados para um sistema de memória quântica que armazenava os fótons dentro de uma nuvem de átomos de rubídio. Um laser “ligava” e “desligava” a memória, permitindo que os fótons fossem armazenados e liberados sob demanda.
estabelecendo as bases para a Internet Quântica
Não só o comprimento de onda destes dois dispositivos corresponde, como também está no mesmo comprimento de onda das redes de telecomunicações utilizadas atualmente – permitindo que seja transmitido com cabos de fibra ótica normais, familiares às ligações diárias à Internet.
Colaboração Europeia
A fonte de luz de pontos quânticos foi criada por pesquisadores da Universidade de Stuttgart com o apoio da Universidade de Wurzburg, e depois trazida para o Reino Unido para fazer interface com o dispositivo de memória quântica criado pela equipe Imperial e de Southampton. O sistema foi montado em um laboratório subterrâneo do Imperial College London.
“O avanço desta vez foi reunir especialistas para desenvolver e executar cada parte do experimento com equipamentos especializados e trabalhar juntos para sincronizar os dispositivos.” - Dr.
Embora tenham sido criados pontos quânticos independentes e memórias quânticas que são mais eficientes do que o novo sistema, esta é a primeira prova de que os dispositivos podem ser feitos para interface, e em comprimentos de onda de telecomunicações.
estabelecendo as bases para a Internet Quântica
A equipe agora tentará melhorar o sistema, inclusive garantindo que todos os fótons sejam produzidos no mesmo comprimento de onda, melhorando por quanto tempo os fótons podem ser armazenados e tornando todo o sistema menor.
No entanto, como prova de conceito, este é um passo importante, diz o coautor Dr. Patrick Ledingham, da Universidade de Southampton: “Os membros da comunidade quântica têm tentado ativamente esta ligação há algum tempo. Isso inclui nós, que já tentamos esse experimento duas vezes antes com diferentes dispositivos de memória e pontos quânticos, há mais de cinco anos, o que só mostra o quão difícil é fazer isso.
estabelecendo as bases para a Internet Quântica
“O avanço desta vez foi reunir especialistas para desenvolver e executar cada parte do experimento com equipamentos especializados e trabalhar juntos para sincronizar os dispositivos.”
Referência: “Armazenamento determinístico e recuperação de luz de telecomunicações a partir de um ponto quântico único
fóton
Um fóton é uma partícula de luz. É a unidade básica da luz e de outras radiações eletromagnéticas e é responsável pela força eletromagnética, uma das quatro forças fundamentais da natureza. Os fótons não têm massa, mas têm energia e momento. Eles viajam à velocidade da luz no vácuo e podem ter diferentes comprimentos de onda, que correspondem a diferentes cores de luz. Os fótons também podem ter energias diferentes, que correspondem a diferentes frequências de luz.
" dados-gt-translate-attributes="[{["atributo":"data-cmtooltip", "formatar":"HTML"]" tabindex="0" role="link">fóton fonte interligada com uma memória quântica atômica” por Sarah E. Thomas, Lukas Wagner, Raphael Joos, Robert Sittig, Cornelius Nawrath, Paul Burdekin, Ilse Maillette de Buy Wenniger, Mikhael J. Rasiah, Tobias Huber-Loyola, Steven Sagona-Stophel, Sven Höfling, Michael Jetter, Peter Michler, Ian A. Walmsley, Simone L. Portalupi e Patrick M. Ledingham, 12 de abril de 2024, Avanços da Ciência.
DOI: 10.1126/sciadv.adi7346
A pesquisa faz parte do projeto financiado pela UE 'Qurope: repetidores quânticos usando emaranhamento fotônico sob demanda'.

 Resultados de pesquisa melhores e mais rápidos
Algolia é uma “Pesquisa como serviço”. Você fornece o conteúdo a eles e eles fornecem uma API para pesquisa.





 Tim Berners-Lee diz que existe um monopólio na IA, mas que isso deve acabar